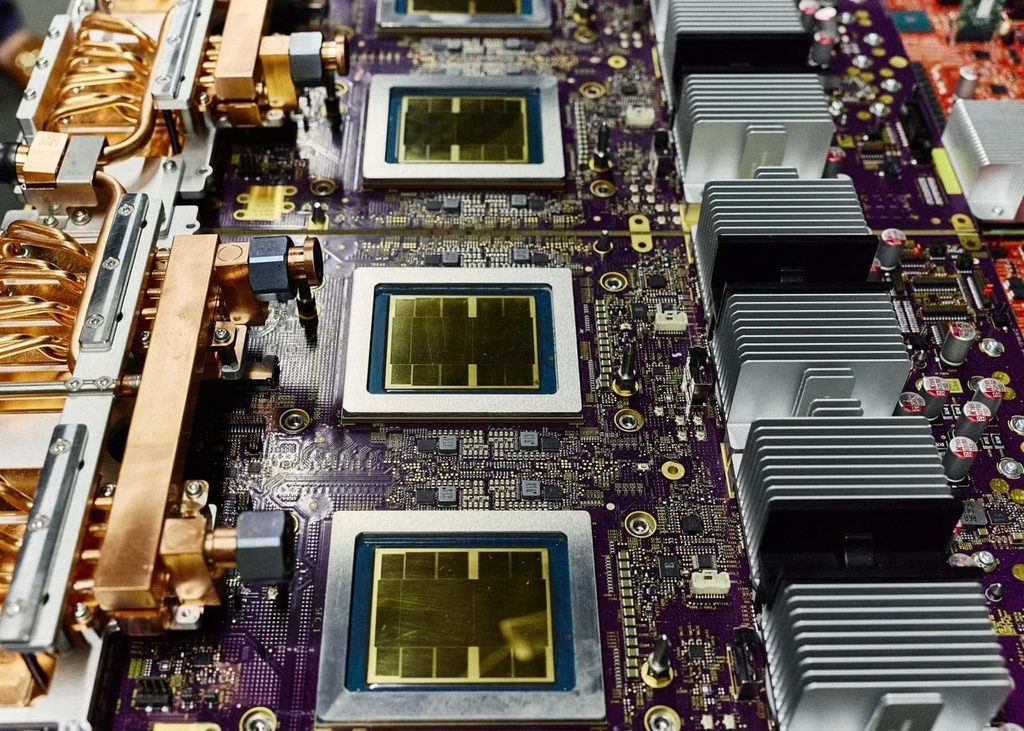
El tablero del silicio para inteligencia artificial acelera su fragmentación. Google ha ampliado formalmente su catálogo de aceleradores propietarios con la presentación de las nuevas TPU 8tx y TPU 8i Max, dos procesadores tensoriales especializados diseñados para disputar la hegemonía de las GPUs de Nvidia en el mercado corporativo de centros de datos.
La maniobra consolida un cambio de ritmo en Mountain View: la división de semiconductores de Google ha abandonado su cadencia histórica de un chip cada dos años para lanzar múltiples arquitecturas de manera simultánea. Según proyecciones de Bloomberg Intelligence, la venta directa y licenciamiento de chips TPU —al margen del consumo interno de Google Cloud— generará más de 135.000 millones de dólares para 2028, una cifra que pulveriza los 12.000 millones estimados para el ejercicio actual.
Especialización frente a propósito general: arquitectura de las TPU 8tx y 8i Max
Bajo la dirección de Amin Vahdat, vicepresidente de infraestructura y computación de Google, la compañía defiende que la era de los chips de propósito general monolíticos está cediendo terreno ante la optimización por cargas de trabajo. Ambos silicios son reconfiguraciones avanzadas de su arquitectura base orientadas a casos de uso concretos:
- TPU 8tx (Cómputo confidencial junto a AMD): Diseñada para sectores bajo estricta regulación (banca, defensa y agencias gubernamentales). A diferencia de los sistemas tradicionales —que deben descifrar los paquetes de información en la memoria volátil antes de que la GPU los procese—, la TPU 8tx cifra y procesa los datos directamente a nivel de silicio. El sistema opera de forma integrada con procesadores CPU de AMD.
- TPU 8i Max (Ventanas de contexto extremas e inferencia): Integra dos núcleos TPU en un mismo encapsulado (dual-die package), multiplicando el ancho de banda y la densidad de memoria disponible. Está concebida específicamente para modelos de razonamiento e inferencia con millones de tokens de contexto, un factor crítico en descubrimiento de fármacos, análisis cuantitativo y desarrollo de software autónomo.
| Parámetro técnico / Comercial | Google TPU 8tx | Google TPU 8i Max |
| Enfoque de diseño | Computación confidencial y seguridad | Inferencia masiva y contexto ultraextenso |
| Arquitectura de empaquetado | Integración segura con CPUs AMD | Diseño dual-chip en un mismo sustrato |
| Diferenciador técnico | Cifrado directo en silicio sin desencriptar en RAM | Duplicación de memoria y capacidad de procesamiento |
| Sectores objetivo | Defensa, administración pública y sanidad | Farmacéutica, matemáticas complejas y programación |
| Coste relativo vs. Nvidia | ~30 % más económica por unidad de cálculo | Alta eficiencia energética en inferencia continuada |
| Disponibilidad comercial | Próximo ejercicio (2027) | Próximo ejercicio (2027) |
Guerra de alianzas: de Oracle y Apple a la diversificación de la cadena de suministro
La cartera de clientes de las TPU ha dejado de ser un asunto interno de Alphabet. Firmas de primer orden como Apple, Meta, Jump Trading y Oracle ya operan flujos de trabajo sobre estas placas. Oracle, de hecho, incorporará las TPU de Google en su catálogo de nube a partir del próximo año, rompiendo su dependencia histórica exclusiva de Nvidia y AMD. Por su parte, Anthropic cuenta con opciones regulatorias para adquirir hasta 150.000 millones de dólares en TPU hacia finales de la década, mientras OpenAI explora acuerdos similares.
Sin embargo, el cuello de botella que frena a Google es el mismo que golpea a Nvidia: la escasez mundial de obleas de memoria y capacidad de empaquetado litográfico. Toda la capacidad actual de las TPU para este ejercicio ya está reservada.
Para sortear la asfixia logística, el equipo de Amin Vahdat está rompiendo el monopolio de Broadcom —su socio de diseño histórico— integrando a Marvell Technology en los desarrollos y sumando soporte de MediaTek, con el fin de diversificar fundiciones y asegurar contratos de suministro a largo plazo.
La factura eléctrica le doblará el brazo a la fuerza bruta de Nvidia
El movimiento de Google con las TPU 8tx y 8i Max ataca el talón de Aquiles de Nvidia: la factura de la luz y el coste total de propiedad (TCO).
Jensen Huang construyó el imperio de Nvidia bajo la premisa de la fuerza bruta: GPUs colosales y universales gobernadas por el ecosistema de software cerrado CUDA. Ese modelo funcionó a la perfección durante la fase de entrenamiento inicial de los grandes modelos de lenguaje (LLMs), donde las compañías no reparaban en gastos para no quedarse atrás. Pero en 2026 nos encontramos en la fase de inferencia masiva y despliegue de agentes: los modelos ya están entrenados y ahora tienen que responder a millones de consultas por segundo sin que el coste operativo hunda la cuenta de resultados de las tecnológicas.

Un chip TPU que rinde de forma competitiva costando un 30 % menos y consumiendo una fracción de los vatios por token procesado es un torpedo directo a la línea de flotación de las GPUs tradicionales. La alianza de Google con AMD para la TPU 8tx demuestra, además, una enorme inteligencia táctica: une a dos rivales directos de Nvidia para ofrecer una plataforma confidencial que los gobiernos y los bancos pueden adoptar sin miedo a filtraciones de memoria.
La vulnerabilidad de Google no reside en la arquitectura de sus procesadores, sino en su propia naturaleza corporativa: venderle silicio a Oracle, Meta o Jump Trading exige actuar como un proveedor de hardware neutral y fiable, un negocio muy alejado de la cultura clásica de Mountain View, propensa a cancelar proyectos de la noche a la mañana. Si Google garantiza el suministro frente a la crisis de memoria y logra que los desarrolladores dejen de depender ciegamente de CUDA, el trono absoluto de Nvidia en los centros de datos empezará a tambalearse mucho antes de lo que Wall Street anticipa.
¡Te leemos en los comentarios! Y no te olvides de seguir a Gurú Tecno en YouTube, Instagram y Facebook.

