La escasez estructural de componentes semiconductores continúa marcando el debate tecnológico global. En una extensa charla en el podcast Cheeky Pint, el director ejecutivo de OpenAI, Sam Altman, abordó la crisis de suministro de memoria y lanzó una advertencia directa contra una de las corrientes más populares entre desarrolladores y entusiastas: la ejecución de modelos de inteligencia artificial en local mediante ordenadores personales.
Para Altman, en un contexto de restricción física severa en la fabricación de chips, acaparar memoria en equipos domésticos para realizar inferencia local supone un reparto ineficiente de los recursos mundiales frente a la centralización en centros de datos.
La tesis de Altman: Inferencia local frente a saturación en la nube
Durante la entrevista, Altman analizó el cuello de botella de la potencia de cómputo y la memoria DRAM, señalando que la intuición colectiva sobre cómo resolver el problema choca directamente con la realidad de las cadenas de suministro: «Creo que el funcionamiento de las cadenas de suministro es muy poco intuitivo. Por ejemplo, mucha gente quiere inferencia local y de algún modo asume que el problema ya está resuelto porque tenemos modelos de código abierto, podemos ejecutarlos en nuestros propios ordenadores y así no necesitamos todo eso en los centros de datos. Pero, desde una perspectiva de asignación global de recursos, en realidad es bastante terrible que todo el mundo tenga acaparada una parte de la limitada oferta mundial de DRAM sentada en su propio ordenador y utilizándose el 5 % del tiempo. Lo que buscas en un entorno con restricciones de suministro tan severas es la máxima utilización en la nube, y aun así la intuición de muchísima gente es exactamente la contraria».
Las declaraciones de Altman se producen en un momento de tensión industrial, marcado por las advertencias de fabricantes como Samsung Electronics sobre la escasez de DRAM convencional y memoria de alto ancho de banda (HBM), una situación tensionada por el despliegue de infraestructuras de IA que amenaza con extender el encarecimiento de componentes hasta 2028.
La falacia del argumento: Los ordenadores no son servidores dedicados
Pese a la lógica matemática de Altman sobre la tasa de ocupación por vatio en un centro de datos, la analogía ignora la naturaleza misma de la informática personal.
Un usuario particular no adquiere 32 GB, 64 GB o 128 GB de memoria RAM para operar una máquina de inferencia 24/7 con márgenes de amortización empresarial. Esos módulos de memoria se utilizan de forma simultánea para ejecutar videojuegos de alta exigencia, software de modelado 3D, edición audiovisual profesional, entornos de compilación o la propia carga multitarea del sistema operativo.
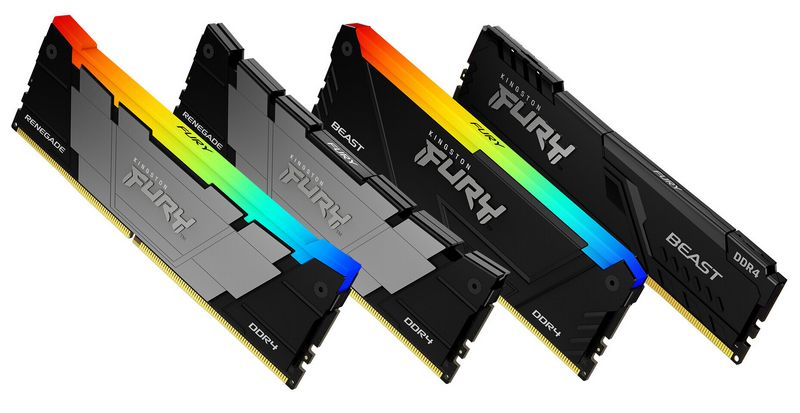
Calificar de «desperdicio» que la memoria de un usuario no trabaje al 100 % de su ciclo continuo equivale a exigir que un vehículo particular deba estar en movimiento constante para justificar el acero con el que fue ensamblado. Reducir la DRAM doméstica a un recurso ocioso no solo desvirtúa el propósito del PC como estación de trabajo independiente, sino que ignora la motivación de quienes recurren a modelos locales: la soberanía de datos, la privacidad estricta y la ausencia de cuotas mensuales o censura algorítmica.
La nube infinita de Sam Altman no quiere que seas dueño de tu silicio
Detrás del discurso de eficiencia global de Sam Altman se esconde una evidente defensa corporativa del modelo de negocio de OpenAI.
A los proveedores de plataformas propietarias en la nube no les inquieta la escasez física de la DRAM en términos ecológicos o de equidad; lo que les preocupa es la fuga de usuarios hacia alternativas abiertas y locales. Cada modelo Llama, Mistral o DeepSeek ejecutado sobre una tarjeta gráfica doméstica es una suscripción menos, una llamada a la API que no factura y una base de usuarios que escapa a la recopilación de datos de sus plataformas.
El argumento de que el consumidor «acapara» silicio mientras la nube «lo aprovecha mejor» plantea un escenario inquietante: una industria donde el hardware de consumo se recorte y encarezca deliberadamente para que toda la potencia de cálculo quede cautiva en macrocentros de datos gestionados por un puñado de corporaciones. Decirle a un jugador o a un creador de contenido que su RAM está «desperdiciada» porque no procesa tokens de ChatGPT el 95 % del tiempo que duerme evidencia hasta qué punto Silicon Valley empieza a ver la propiedad del hardware personal como una anomalía que corregir.
Déjanos tu opinión en los comentarios y únete a la discusión en Instagram, Facebook y YouTube.

